從構想、規劃、試錯到完成深度學習的手勢辨識模型。
 |
| reference from Mark Robins |
第6關
Training Model & Next Step
當前期充分準備後,後續訓練模型的過程反而沒花那麼多時間。
在建立訓練模型的過程中,反覆測試的過程是難以避免的。
比較值得一提的是測試中發現,模型層數增減影響結果甚為重要,
如果參數太少,在訓練的過程中很快就會發現 loss & accuracy 數值很不理想,
也就沒有必要再繼續跑下去。

但究竟該怎麼設定多寡?
坦白說目前也只有累積經驗值才知 (還請高手賜教)。
關於細節請參考GitHub
Static Gesture Recognition @ GitHub
DEMO
What’s next?
儘管完成了初階段目標,但仍有很多方向值得觀察、改善、繼續深究:
● 誤判情形:
當在ROI範圍內迅速切換時,無可避免的是轉換手勢的過程中難免會出現誤判情形,
這是因為webcam不停地擷取影像資訊交給模型預測,在切換的過程中一定會出現非既定圖像的情況,
不過變換的時間只有一下子所以也不會造成太大影響。
實際應用時,應考慮接收手勢持續的時間後(如2秒內)再進行決定採用何種行為,應可有效降低誤判機率。
● 效能表現:
實際在PC上測試,以CPU Intel i5-3470 3.2G, RAM 8G, OS: Win10 硬體為例
執行時CPU使用率高達85+%。

假設在真正進行判斷之前,先進行 Hand Detection,之後再行gesture recognition,
是否有降低消耗資源的可能性? (前提是Hand Detection 比起 Gesture Recognition有更好的性能消耗比)
或是降低模型的隱藏層數是否也是可能的方向? 都還有待繼續探索驗證。
● 更貼近真實的使用情境:
由於使用的是1 channel灰階圖案,且實際場景與訓練圖片也是刻意去除背景,
未必能完全適用在真實的複雜情境上。若要更廣泛的情境判斷,就必須有更大量的真實圖片提供訓練。抑或是有其他方式?
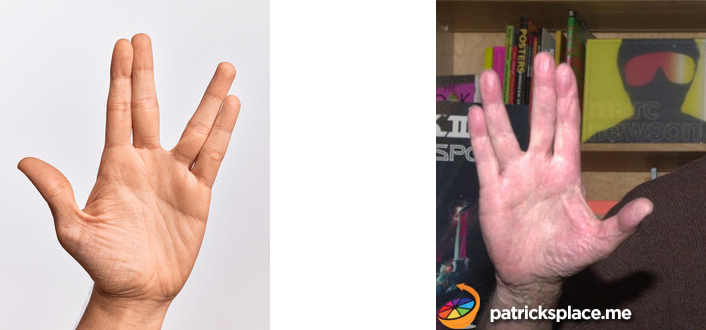 |
| simple & complex background |
● 擴充的可能:
是否在預訓練的模型上繼續擴充使用這套模型呢 ? 但本專題使用的是單通道灰階圖像,必須要重新設定蒐集訓練圖片才行。
● 動態手勢追蹤:
這個模型現階段僅能辨識靜態手勢,如果能進一步識別動態手勢,應用層面想必能更加擴大活躍!
● 更輕量的檔案大小與裝置:
由於單一模型就有591MB,為了提高效率,採用權重+結構是不可或缺的做法,但即使權重也高達197MB。
若減少隱藏層數是否能達到有效降低檔案大小的目標?
到移動性高但可能資源有限的輕量硬體使用,如行動裝置、或樹莓派的可能性?
後記:
這篇心得記錄是不斷反覆試錯 + 參考網友無私分享的教學文所摸索出來的心得。
當學習越多,越發覺得不足之處越多。
對於深度學習用的數學公式與理論,自慚資質駑鈍無法參透,只知如何使用。
因此這系列文僅記錄自己的開發/檢討/除錯的過程與思路邏輯,
並不打算描述太多程式的做法,畢竟只是野人獻曝罷了。
有需要的朋友們可自行至 Static Gesture Recognition @ Github 參考。
並希望這系列記錄也能提供給初心者的同好們,
作為一篇打造屬於你自己的影像辨識模型之基礎入門說明書,
若能在學習的路上對你有所幫助,我也感到非常榮幸。
Series link:
[DL]Static Gestures Recognition(1): Conception
[DL]Static Gestures Recognition(2): Solution finding
[DL]Static Gestures Recognition(3): Define workflow
[DL]Static Gestures Recognition(4): Preparing appropriate dataset
[DL]Static Gestures Recognition(5): Time is worth more than money
[DL]Static Gestures Recognition(6): Training Model & Next Step


